

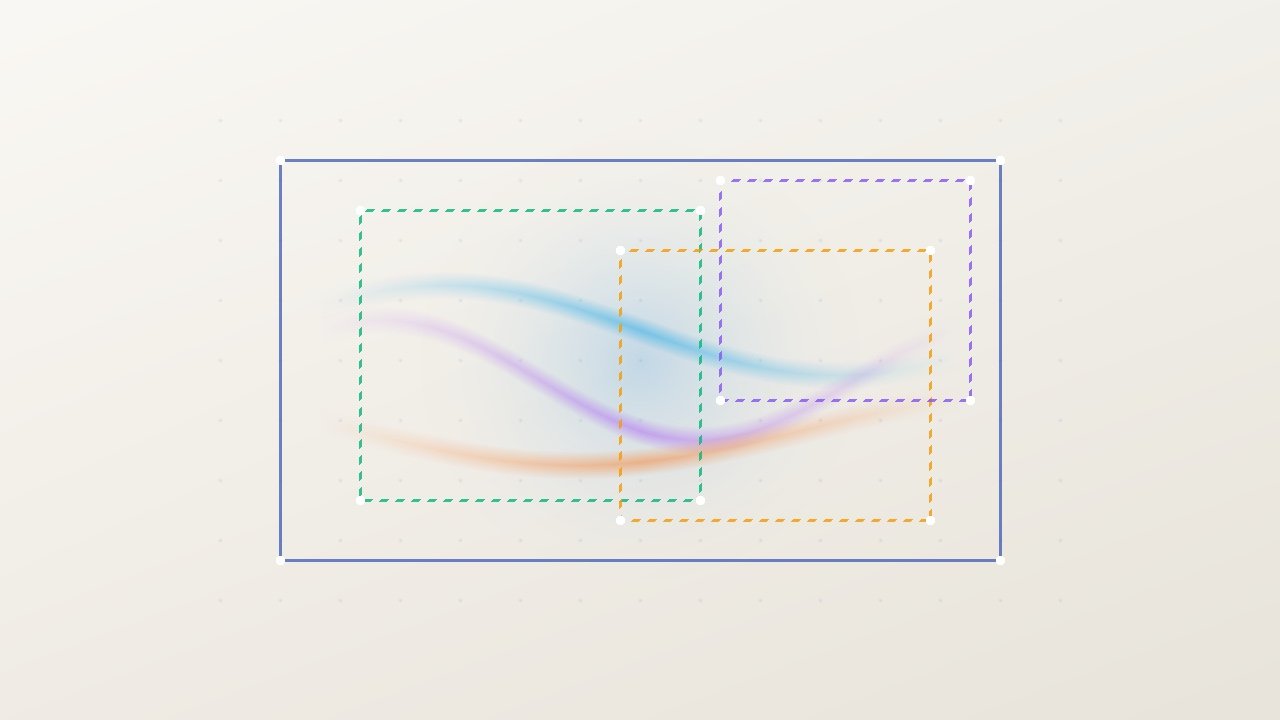
FLUX.3 Image Klein marque une avancée technique majeure dans l’écosystème de la génération d’images en poids ouverts. Développé par Black Forest Labs et intégré dès le premier jour dans la bibliothèque Diffusers de Hugging Face, ce modèle introduit un contrôle de mise en page spatial direct par boîtes englobantes sans nécessiter d’adaptateur externe. Il permet aux créateurs et développeurs de composer des scènes visuelles complexes en spécifiant précisément l’emplacement de chaque élément.
- Contrôle spatial natif : placement direct des éléments via des coordonnées de boîtes englobantes intégrées au prompt textuel.
- Génération en 2 secondes : la variante distillée produit une image 1024 × 1024 en 16 étapes sur un seul GPU NVIDIA H100.
- Encodeur Qwen3-VL : extraction enrichie sur huit couches intermédiaires cumulant 20 480 dimensions pour une fidélité sémantique accrue.
- Quantification accessible : formats FP8 et NVFP4 exploitables sur des GPU grand public dès 16 Go de VRAM.
- Édition multi-référence : déplacement et transformation d’objets précis au sein d’une image tout en figeant le décor.
Sommaire :
Contrôle spatial et boîtes englobantes dans FLUX.3 Image Klein
Jusqu’à présent, diriger avec rigueur la composition d’une scène générée par un réseau neuronal imposait l’utilisation d’outils complémentaires comme ControlNet ou d’astuces de masquage complexes. Avec FLUX.3 Image Klein, Black Forest Labs change la donne en intégrant la gestion spatiale au cœur même du processus de diffusion.
Le fonctionnement repose sur une syntaxe normalisée ajoutée à la suite de la description textuelle. L’utilisateur définit une liste de régions comprenant un identifiant, une boîte englobante normalisée sur une échelle de 0 à 1 000, et une description textuelle ciblée. Le modèle associe chaque zone à son contenu respectif sans déborder sur les régions adjacentes.
Cette approche résout l’un des problèmes historiques les plus frustrants des générateurs visuels : la contamination sémantique, où les couleurs ou attributs d’un objet bavent sur son voisin. En fixant explicitement les coordonnées spatiales, vous obtenez une composition rigoureuse dès le premier jet.
Le contrôle s’étend également à la modification d’images existantes en mode image-vers-image multi-référence. Vous pouvez désigner la boîte source d’un objet dans une image de référence et indiquer sa boîte cible dans le rendu final. Le modèle déplace le sujet tout en préservant l’arrière-plan, les éclairages et les textures d’origine avec une cohérence remarquable.
Architecture modulaire et encodeur visuel Qwen3-VL
Sur le plan structurel, le modèle s’appuie sur une évolution de l’architecture de flux continu en espace latent déjà éprouvée par Black Forest Labs. Cependant, le traitement du texte et des conditions visuelles a été profondément repensé.
Plutôt que d’utiliser un modèle de langage classique, l’architecture exploite Qwen3-VL, un modèle vision-langage de pointe. Le pipeline ne se contente pas de récupérer la dernière couche du modèle textuel : il extrait et empile les états cachés de huit couches distinctes (notamment les couches 4, 8, 12 jusqu’à 32). Chaque jeton textuel est ainsi encodé dans un vecteur massif de 20 480 dimensions avant d’être projeté vers l’espace latent du transformeur.
Le transformeur fonctionne en deux étapes successives au sein de son bloc d’attention. La première étape applique des blocs spécifiques à chaque flux : le texte, le bruit de l’image en cours de génération et les images de référence disposent de leurs propres couches de calcul indépendantes. La seconde étape rassemble l’ensemble de ces flux au sein de 28 blocs conjoints où tous les jetons peuvent interagir et s’ajuster mutuellement.
Cette séparation nette garantit que les particularités de chaque modalité sont affinées avant d’être fusionnées. Cette conception sophistiquée enrichit la compréhension des relations spatiales et renforce les capacités déjà visibles dans notre sélection des modèles d’intelligence artificielle de pointe.
Performances matérielles et formats quantifiés de FLUX.3 Image Klein
L’exécution de FLUX.3 Image Klein s’avère particulièrement flexible grâce au travail d’optimisation mené conjointement avec Hugging Face. Deux points de contrôle principaux sont mis à disposition de la communauté dans le dépôt officiel :
| Format / Variante | Mémoire VRAM crête | Vitesse (1024 × 1024) | Étapes d’inférence | Usage principal |
|---|---|---|---|---|
| Distillé (bf16) | 20,72 Go (inférence) | 1,93 seconde (H100) | 16 pas (sans CFG) | Production rapide et prototypage |
| Base (bf16) | 23,80 Go (inférence) | ~5,5 secondes (H100) | 50 pas (guidage CFG 5.0) | Qualité maximale et fine-tuning LoRA |
| Quantifié FP8 (fp8r) | 16,27 Go (inférence) | ~2,8 secondes (Ada/Hopper) | 16 pas | Cartes grand public (RTX 4090) |
| Quantifié NVFP4 | 15,30 Go (inférence) | ~2,1 secondes (Blackwell) | 16 pas | Architectures de dernière génération |
Pour les configurations disposant de moins de mémoire vidéo, Diffusers propose une gestion automatisée du déchargement sur processeur central (CPU offloading). Grâce à ce mécanisme, le modèle ne charge chaque composant sur la carte graphique que pendant sa phase active d’exécution, permettant de faire tourner l’inférence sur des machines de bureau standards.
Ce niveau d’accessibilité technique confirme l’importance croissante des modèles open weight pour les créateurs qui souhaitent garder une autonomie complète sur leur infrastructure logicielle sans dépendre d’API fermées.
Entraînement LoRA et cas d’usage professionnels
Au-delà de la simple génération ponctuelle, FLUX.3 Image Klein a été pensé comme un socle adaptable pour les flux de production industriels. Les scripts d’entraînement DreamBooth LoRA sont disponibles dès le lancement dans Diffusers, couvrant aussi bien la synthèse textuelle que la retouche guidée par instructions.
Cette adaptabilité ouvre des perspectives concrètes pour les équipes marketing, les agences de design et les commerçants en ligne. Une marque peut par exemple entraîner un adaptateur léger sur ses produits ou sur une charte graphique spécifique, tout en exploitant le placement par boîtes englobantes pour insérer son produit dans une mise en scène commerciale calibrée au millimètre.
Dans le domaine du commerce électronique, les graphistes peuvent convertir un simple cliché produit en une série de déclinaisons de catalogue en quelques secondes. Les studios d’architecture peuvent quant à eux tester des variations d’éclairage ou de matériaux sur des volumes précis sans altérer les structures porteuses environnantes.
Cette précision spatiale transforme en profondeur les flux de travail créatifs en éliminant les allers-retours aléatoires liés au rééchantillonnage de prompts imprécis. Elle préfigure également une intégration naturelle dans les pipelines automatisés, à l’image des scénarios décrits dans notre comparatif des agents IA.
Foire aux questions sur FLUX.3 Image Klein
Comment fonctionne le contrôle de mise en page dans FLUX.3 Image Klein ?
Le contrôle s’effectue directement dans le prompt sous la forme d’un tableau JSON définissant des boîtes englobantes avec des coordonnées normalisées comprises entre 0 et 1 000. Chaque zone est liée à une description précise que le transformeur dessine spécifiquement dans la région délimitée.
Quelle configuration matérielle minimale faut-il pour faire tourner FLUX.3 Image Klein ?
En utilisant le format quantifié FP8 ou NVFP4 avec la variante distillée, une carte graphique disposant de 16 Go de VRAM suffit pour exécuter le modèle en local. L’activation du déchargement CPU permet d’exécuter l’outil sur des configurations plus modestes au prix d’une vitesse de calcul réduite.
Quelles sont les différences entre la version distillée et le modèle de base ?
La version distillée génère des images en 16 étapes sans guidage sans classificateur (CFG) en moins de 2 secondes sur GPU professionnel. Le modèle de base nécessite 50 étapes avec guidage CFG et sert de point de départ privilégié pour entraîner des adaptateurs LoRA personnalisés.
Comment entraîner un adaptateur LoRA personnalisé sur FLUX.3 Image Klein ?
Hugging Face fournit des scripts officiels DreamBooth compatibles avec les bibliothèques Diffusers et Accelerate. Il suffit de préparer un jeu de données annoté pour entraîner un adaptateur textuel ou un module de retouche d’image en exploitant le point de contrôle de base.
En résumé, l’arrivée de FLUX.3 Image Klein pose un nouveau jalon technique pour la synthèse d’images ouvertes. Grâce à l’association d’un contrôle spatial rigoureux, d’un encodeur visuel puissant et d’une intégration logicielle exemplaire dans Diffusers, ce modèle offre aux créateurs une liberté d’exécution inédite sans les contraintes habituelles des services propriétaires.
Sources et ressources complémentaires :